Monitoring Kubernetes with VictoriaMetrics and Grafana
Overview#
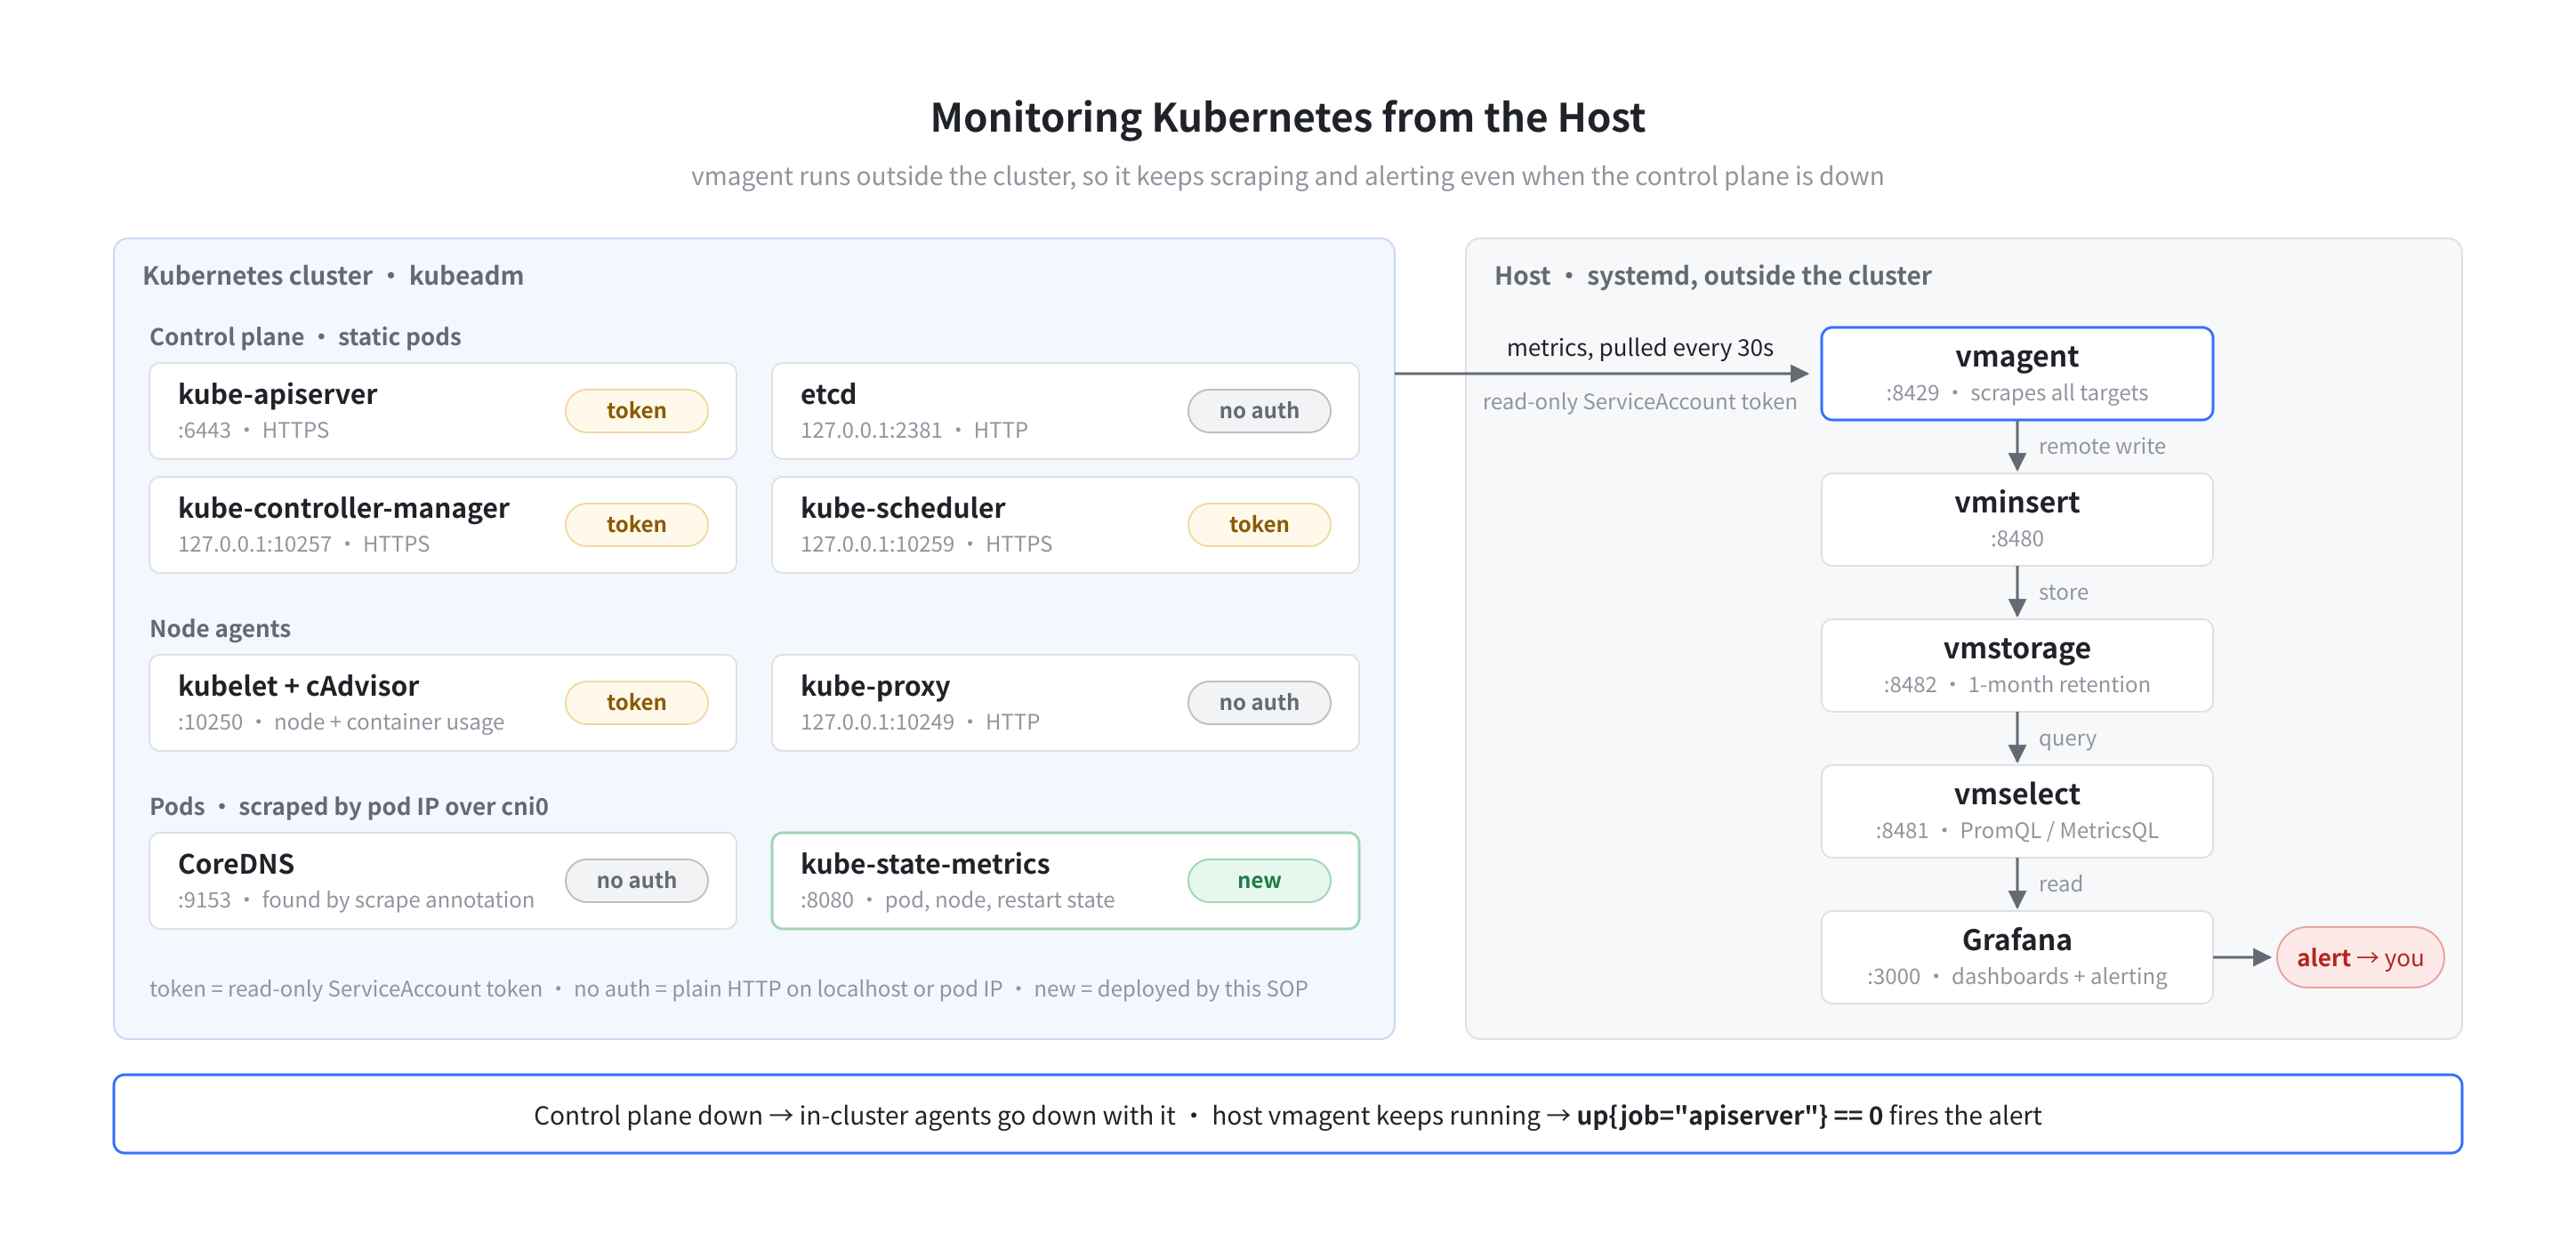
This SOP adds Kubernetes monitoring to a VictoriaMetrics + Grafana stack that already exists on the host (systemd services, outside the cluster). The cluster is the single-node kubeadm setup from k8s cluster setup on Raspberry Pi.
Starting point:
| Component | How it runs | Role |
|---|---|---|
| vmagent | systemd, host | scrapes targets, remote-writes to vminsert |
| vminsert / vmstorage / vmselect | systemd, host | VictoriaMetrics cluster, 1-month retention |
| Grafana | systemd, host | datasource → vmselect :8481/select/0/prometheus |
| node_exporter | systemd, host | node-level metrics (already scraped) |
| Kubernetes | kubeadm, single node, Flannel | not monitored yet |
Goal: monitor the control plane, the node, and workloads — and get alerted when the cluster goes down.
1. Why monitor from the host, not from inside the cluster#
There are two common shapes:
| A. Host vmagent + kube-state-metrics | B. victoria-metrics-k8s-stack Helm chart |
|
|---|---|---|
| New components | kube-state-metrics only | operator, CRDs, in-cluster vmagent, ~5 pods |
| Needs Helm | No | Yes |
| Dashboards / alerts | Import yourself | Bundled |
| Survives a cluster outage | Yes — vmagent is a systemd service | No — dies with the apiserver |
The last row decides it. When the control plane is down, an in-cluster agent goes down with it and stays silent. A host-level vmagent keeps scraping and can alert apiserver is down.
A second reason: kubeadm binds most control-plane metrics to 127.0.0.1. A vmagent on the control-plane host can reach them as-is — no kubeadm config changes.
2. Feasibility: what can vmagent reach today#
Probe each endpoint from the host before changing anything:
# plain HTTP, no auth — should return metric lines
curl -s http://127.0.0.1:2381/metrics  | grep -c '^etcd_'
curl -s http://127.0.0.1:10249/metrics | grep -c '^kubeproxy_'

# HTTPS, needs a token — expect 401/403 without one
for p in 6443 10250 10257 10259; do
  printf "%s -> " $p
  curl -sk -o /dev/null -w '%{http_code}\n' https://127.0.0.1:$p/metrics
done

# pod network — the host can reach pod IPs directly through cni0
COREDNS=$(kubectl get pod -n kube-system -l k8s-app=kube-dns -o jsonpath='{.items[0].status.podIP}')
curl -s -o /dev/null -w '%{http_code}\n' http://$COREDNS:9153/metrics
| Endpoint | Result | Needed |
|---|---|---|
etcd 127.0.0.1:2381 |
metrics | nothing |
kube-proxy 127.0.0.1:10249 |
metrics | nothing |
apiserver :6443 |
403 | token |
kubelet / cAdvisor :10250 |
401 | token |
controller-manager :10257 |
403 | token |
scheduler :10259 |
403 | token |
CoreDNS pod :9153 |
200 | nothing |
So the work is: one read-only ServiceAccount token, one in-cluster component (kube-state-metrics), and new scrape jobs.
3. Sizing#
Measure the current footprint first:
curl -s 'http://localhost:8481/select/0/prometheus/api/v1/status/tsdb' \
  | python3 -c "import sys,json; print(json.load(sys.stdin)['data']['totalSeries'])"
sudo du -sh /var/lib/vmstorage
On this setup: ~5.3k series at 15s used ~214 MB for a month — about 0.23 bytes/sample. Using that ratio:
| Setup | Series | Disk / month |
|---|---|---|
| everything, 15s, no filtering | ~25–40k | ~1–2 GB |
| 30s interval + drop heavy histogram buckets | ~15–20k | ~0.4–0.6 GB |
On an SD card, scrape Kubernetes at 30s and drop the largest histograms. The extra RAM (kube-state-metrics ~50–100 MB) is negligible.
4. SOP#
Step 0 — Back up the scrape config#
sudo cp -a /etc/vmagent/scrape.yml /etc/vmagent/scrape.yml.bak-$(date +%F)
Step 1 — Read-only ServiceAccount for vmagent#
kubectl create namespace monitoring

kubectl apply -f - <<'EOF'
apiVersion: v1
kind: ServiceAccount
metadata: { name: vmagent, namespace: monitoring }
---
# long-lived token, since vmagent runs outside the cluster
apiVersion: v1
kind: Secret
metadata:
  name: vmagent-token
  namespace: monitoring
  annotations: { kubernetes.io/service-account.name: vmagent }
type: kubernetes.io/service-account-token
---
apiVersion: rbac.authorization.k8s.io/v1
kind: ClusterRole
metadata: { name: vmagent-read }
rules:
- apiGroups: [""]
  resources: [nodes, nodes/metrics, services, endpoints, pods]
  verbs: [get, list, watch]
- apiGroups: [discovery.k8s.io]
  resources: [endpointslices]
  verbs: [get, list, watch]
- nonResourceURLs: [/metrics, /metrics/cadvisor]
  verbs: [get]
---
apiVersion: rbac.authorization.k8s.io/v1
kind: ClusterRoleBinding
metadata: { name: vmagent-read }
roleRef: { apiGroup: rbac.authorization.k8s.io, kind: ClusterRole, name: vmagent-read }
subjects: [{ kind: ServiceAccount, name: vmagent, namespace: monitoring }]
EOF
Hand the token and cluster CA to the host vmagent (check the service user with systemctl show -p User vmagent):
kubectl -n monitoring get secret vmagent-token -o jsonpath='{.data.token}' \
  | base64 -d | sudo tee /etc/vmagent/k8s-token >/dev/null
sudo cp /etc/kubernetes/pki/ca.crt /etc/vmagent/k8s-ca.crt
sudo chown victoriametrics: /etc/vmagent/k8s-token /etc/vmagent/k8s-ca.crt
sudo chmod 0640 /etc/vmagent/k8s-token

# both should print "yes"
kubectl auth can-i get nodes/metrics --as=system:serviceaccount:monitoring:vmagent
kubectl auth can-i get /metrics      --as=system:serviceaccount:monitoring:vmagent
Step 2 — Deploy kube-state-metrics#
kube-state-metrics turns object state into metrics — pod phase, container restarts, node conditions, deployment replicas. Without it you see resource usage, but not “etcd has restarted 9,000 times”.
# pin a release whose compatibility matrix covers your k8s version (see the KSM README)
# the image is multi-arch, arm64 included
kubectl apply -k 'github.com/kubernetes/kube-state-metrics/examples/standard?ref=<vX.Y.Z>'
kubectl -n kube-system rollout status deploy/kube-state-metrics
Step 3 — Add scrape jobs#
Append to /etc/vmagent/scrape.yml. Replace <node-ip> with the apiserver advertise address.
  # ---------- Kubernetes ----------
  - job_name: apiserver
    scrape_interval: 30s
    scheme: https
    bearer_token_file: /etc/vmagent/k8s-token
    tls_config: { ca_file: /etc/vmagent/k8s-ca.crt }
    static_configs: [{ targets: ['<node-ip>:6443'] }]
    metric_relabel_configs:          # the largest series sources in apiserver metrics
      - source_labels: [__name__]
        regex: 'apiserver_request_body_size_bytes_bucket|apiserver_response_sizes_bucket|apiserver_watch_events_sizes_bucket|apiserver_request_sli_duration_seconds_bucket'
        action: drop

  - job_name: kubelet
    scrape_interval: 30s
    scheme: https
    bearer_token_file: /etc/vmagent/k8s-token
    tls_config: { insecure_skip_verify: true }   # kubeadm kubelet serves a self-signed cert
    kubernetes_sd_configs:
      - role: node
        api_server: https://<node-ip>:6443
        bearer_token_file: /etc/vmagent/k8s-token
        tls_config: { ca_file: /etc/vmagent/k8s-ca.crt }
    relabel_configs:
      - { action: labelmap, regex: __meta_kubernetes_node_label_(.+) }

  - job_name: cadvisor
    scrape_interval: 30s
    metrics_path: /metrics/cadvisor
    scheme: https
    bearer_token_file: /etc/vmagent/k8s-token
    tls_config: { insecure_skip_verify: true }
    kubernetes_sd_configs:
      - role: node
        api_server: https://<node-ip>:6443
        bearer_token_file: /etc/vmagent/k8s-token
        tls_config: { ca_file: /etc/vmagent/k8s-ca.crt }
    metric_relabel_configs:
      - source_labels: [__name__]
        regex: 'container_tasks_state|container_memory_failures_total|container_blkio_device_usage_total'
        action: drop

  - job_name: kube-controller-manager
    scrape_interval: 30s
    scheme: https
    bearer_token_file: /etc/vmagent/k8s-token
    tls_config: { insecure_skip_verify: true }
    static_configs: [{ targets: ['127.0.0.1:10257'] }]

  - job_name: kube-scheduler
    scrape_interval: 30s
    scheme: https
    bearer_token_file: /etc/vmagent/k8s-token
    tls_config: { insecure_skip_verify: true }
    static_configs: [{ targets: ['127.0.0.1:10259'] }]

  - job_name: etcd
    scrape_interval: 30s
    static_configs: [{ targets: ['127.0.0.1:2381'] }]

  - job_name: kube-proxy
    scrape_interval: 30s
    static_configs: [{ targets: ['127.0.0.1:10249'] }]

  - job_name: kube-state-metrics
    scrape_interval: 30s
    kubernetes_sd_configs:
      - role: endpoints
        api_server: https://<node-ip>:6443
        bearer_token_file: /etc/vmagent/k8s-token
        tls_config: { ca_file: /etc/vmagent/k8s-ca.crt }
    relabel_configs:
      - source_labels: [__meta_kubernetes_service_name, __meta_kubernetes_endpoint_port_name]
        regex: 'kube-state-metrics;http-metrics'
        action: keep

  # any Service annotated prometheus.io/scrape=true
  # kubeadm's kube-dns Service already carries it, so CoreDNS is picked up here
  - job_name: kubernetes-service-endpoints
    scrape_interval: 30s
    kubernetes_sd_configs:
      - role: endpoints
        api_server: https://<node-ip>:6443
        bearer_token_file: /etc/vmagent/k8s-token
        tls_config: { ca_file: /etc/vmagent/k8s-ca.crt }
    relabel_configs:
      - source_labels: [__meta_kubernetes_service_annotation_prometheus_io_scrape]
        regex: 'true'
        action: keep
      - source_labels: [__address__, __meta_kubernetes_service_annotation_prometheus_io_port]
        regex: '([^:]+)(?::\d+)?;(\d+)'
        replacement: '$1:$2'
        target_label: __address__
      - { source_labels: [__meta_kubernetes_namespace], target_label: namespace }
      - { source_labels: [__meta_kubernetes_service_name], target_label: service }
      - { source_labels: [__meta_kubernetes_pod_name], target_label: pod }
Validate, then hot-reload — existing targets keep scraping, no restart:
sudo -u victoriametrics /usr/local/bin/vmagent \
  -promscrape.config=/etc/vmagent/scrape.yml -dryRun
curl -X POST http://localhost:8429/-/reload
Step 4 — Verify#
# every target should be "up"
curl -s localhost:8429/api/v1/targets | python3 -c "
import sys, json
for t in json.load(sys.stdin)['data']['activeTargets']:
    print(t['labels']['job'], t['health'], t.get('lastError', ''))"

# series count should land in the range estimated in § 3
curl -s 'localhost:8481/select/0/prometheus/api/v1/status/tsdb' \
  | python3 -c "import sys,json; print(json.load(sys.stdin)['data']['totalSeries'])"
Common failures:
lastError |
Cause | Fix |
|---|---|---|
401 Unauthorized |
token file empty or unreadable | re-run Step 1 token copy, check owner/mode |
403 Forbidden |
RBAC missing a rule | kubectl auth can-i ... --as=system:serviceaccount:monitoring:vmagent |
x509: certificate signed by unknown authority |
wrong CA for apiserver | ca_file must be /etc/kubernetes/pki/ca.crt |
connection refused on 10257/10259 |
component restarting | check crictl ps on the host |
Step 5 — Grafana dashboards#
Import via Dashboards → New → Import → ID, using the existing VictoriaMetrics datasource. Confirm the IDs on grafana.com before importing.
| ID | Dashboard |
|---|---|
| 15757 | Kubernetes / Views / Global |
| 15758 | Kubernetes / Views / Namespaces |
| 15759 | Kubernetes / Views / Nodes |
| 15760 | Kubernetes / Views / Pods |
| 15761 | Kubernetes / System / API Server |
| 15762 | Kubernetes / System / CoreDNS |
| 13332 | kube-state-metrics v2 |
| 1860 | Node Exporter Full |
Step 6 — Alerting#
Dashboards only help when someone is looking. Start with Grafana’s built-in alerting and these rules:
| Alert | Expression | For |
|---|---|---|
| APIServerDown | up{job="apiserver"} == 0 |
5m |
| EtcdDown | up{job="etcd"} == 0 |
5m |
| NodeNotReady | kube_node_status_condition{condition="Ready",status="true"} == 0 |
5m |
| PodCrashLooping | increase(kube_pod_container_status_restarts_total[15m]) > 3 |
0m |
| ScrapeTargetDown | up == 0 |
10m |
| HostDiskFilling | node_filesystem_avail_bytes{mountpoint="/"} / node_filesystem_size_bytes{mountpoint="/"} < 0.15 |
15m |
APIServerDown and EtcdDown only work because vmagent runs outside the cluster — see § 1. For a larger rule set later, the victoria-metrics-k8s-stack chart publishes rules that can be adapted for vmalert.
5. Rollback#
Every step is independently reversible:
sudo cp /etc/vmagent/scrape.yml.bak-<date> /etc/vmagent/scrape.yml
curl -X POST http://localhost:8429/-/reload

kubectl delete -k 'github.com/kubernetes/kube-state-metrics/examples/standard?ref=<vX.Y.Z>'
kubectl delete clusterrolebinding vmagent-read
kubectl delete clusterrole vmagent-read
kubectl delete namespace monitoring        # also removes the token Secret

sudo rm /etc/vmagent/k8s-token /etc/vmagent/k8s-ca.crt
6. Caveats#
- Single point of failure — cluster, monitoring and alerting share one host. If the host dies, nothing alerts. Add an external dead-man’s switch: Grafana sends a periodic heartbeat to an outside service, which alerts when the heartbeat stops.
- Adding worker nodes — kubelet and cAdvisor are discovered automatically. kube-proxy on a new node binds
127.0.0.1:10249and is unreachable from the control-plane host; setmetricsBindAddress: 0.0.0.0:10249in the kube-proxy ConfigMap. insecure_skip_verify— kubeadm’s kubelet, controller-manager and scheduler serve self-signed certs, so verification is skipped for them. All of those targets are on localhost or the local node.- Token lifetime — the token never expires. It is read-only and readable only by the vmagent user. Revoke with
kubectl -n monitoring delete secret vmagent-token.
Comments